Ein Spitzenplatz beantwortet nicht Ihre Geschäftsfrage
Vergleichstests für KI-Modelle sind nützlich. Sie zeigen, welche Kandidaten bestimmte Aufgaben grundsätzlich beherrschen und wo sich Fähigkeiten weiterentwickeln. Was sie nicht wissen können: Welche Fehler in Ihrem Unternehmen harmlos sind, welche viel Nacharbeit verursachen und welche einen Kunden oder einen wichtigen Vorgang betreffen.
Nehmen wir einen fiktiven technischen Großhandel. Eine KI soll eingehende Anfragen vorsortieren, Produkte zuordnen und einen Antwortentwurf vorbereiten. Ein Modell kann im allgemeinen Test hervorragend abschneiden und trotzdem interne Artikelbezeichnungen verwechseln. Ein anderes formuliert weniger elegant, erkennt aber zuverlässig, wann ihm Angaben fehlen. Für den Betrieb kann die zweite Variante klar wertvoller sein.
Die interessante Frage lautet deshalb nicht: Welches Modell ist insgesamt das beste? Sie lautet: Welches Modell erzeugt in diesem begrenzten Auftrag den besten betrieblichen Ablauf?
Mehr Können kann auch mehr Aufwand bedeuten
Ein leistungsfähigeres Modell bringt oft mehr Möglichkeiten mit. Das ist ein Vorteil, wenn der Prozess diese Möglichkeiten wirklich benötigt. Bei einer klar begrenzten Aufgabe kann es aber auch mehr Kosten, längere Antwortzeiten und schwerer vorhersehbare Ergebnisse bedeuten. Zusätzliche Fähigkeit hat nur dann einen wirtschaftlichen Wert, wenn sie ein relevantes Problem löst.
Im Großhandel muss die KI keine brillante Marktanalyse schreiben. Sie soll erkennen, zu welcher Produktgruppe eine Anfrage gehört, fehlende Informationen benennen und einen brauchbaren Entwurf liefern. Wenn ein kleineres Modell das zuverlässig schafft, ist das größere Modell nicht automatisch die professionellere Wahl.
Dasselbe gilt für AI Agents. Mehr Eigenständigkeit wirkt modern, erweitert aber auch den Raum für Fehlentscheidungen. Wo ein Entwurf genügt, braucht die KI nicht selbstständig Bestände zu ändern oder Nachrichten zu versenden. Gute Architektur zeigt sich oft darin, Fähigkeiten bewusst wegzulassen.
Die versteckten Kosten entstehen nach der Antwort
Viele Vergleiche enden bei Preis pro Anfrage und Qualität des erzeugten Textes. Der größere Kostenblock liegt häufig danach: Mitarbeiter prüfen Angaben, korrigieren Zuordnungen, ergänzen fehlenden Kontext oder klären, warum ein Vorgang falsch weitergeleitet wurde. Diese Nacharbeit entscheidet mit darüber, ob eine Automatisierung tatsächlich Zeit spart.
Für die Modellauswahl würde ich deshalb nicht nur Antworten zählen. Ich würde beobachten, wie oft ein Mensch eingreifen muss, wie lange die Korrektur dauert und welche Fehler wiederkehren. Eine ungeschickte Formulierung ist etwas anderes als eine falsche Produktzuordnung. Beide als einen einzigen Fehler zu verbuchen, verdeckt den Unterschied, der für das Geschäft entscheidend ist.
Auch eine Rückfrage ist nicht automatisch ein Mangel. Wenn eine Kundennummer fehlt, kann eine gezielte Nachfrage professioneller sein als eine plausibel klingende Vermutung. Ein Modell, das seine Grenze an der richtigen Stelle erkennt, kann im Betrieb wertvoller sein als eines, das auf jede Eingabe sofort eine fertige Antwort liefert.
Ein kleiner Praxistest schlägt die große Modell-Debatte
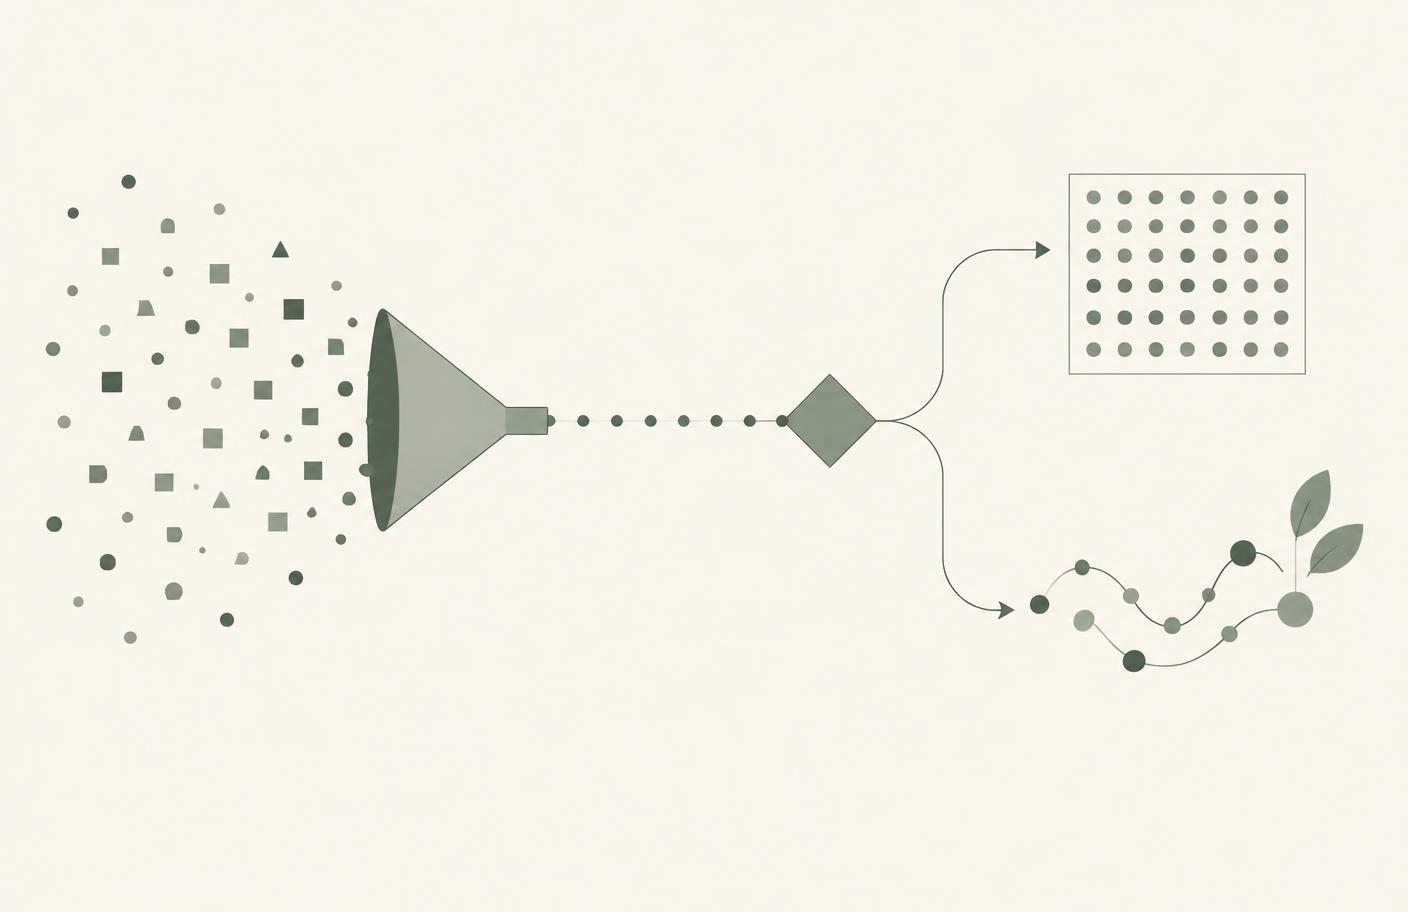
Unternehmen brauchen für eine erste Entscheidung kein eigenes Forschungslabor. Eine überschaubare Sammlung realitätsnaher Fälle liefert bereits mehr Erkenntnis als eine lange Diskussion über Modellnamen. Sie sollte normale Vorgänge, unvollständige Angaben, widersprüchliche Informationen und einige bekannte Problemfälle enthalten. Personenbezogene oder vertrauliche Daten werden dafür nur verwendet, wenn der Umgang klar geregelt ist; häufig reichen bereinigte oder nachgebildete Fälle.
Alle Kandidaten erhalten denselben Auftrag und denselben Informationsstand. Vorher wird festgelegt, woran ein gutes Ergebnis erkennbar ist: richtige Zuordnung, keine erfundenen Angaben, sinnvolle Rückfragen, akzeptable Bearbeitungszeit und vertretbare Kosten. Danach bewertet das Fachteam die Ergebnisse, nicht die Person mit der stärksten Vorliebe für einen bestimmten Anbieter.
Dieser Test muss nicht jede zukünftige Situation beweisen. Er soll eine bessere Entscheidung ermöglichen und problematische Muster sichtbar machen. Werden Prompt, Datenquelle oder Modell später verändert, werden dieselben wichtigen Fälle erneut geprüft.
Die richtige Wahl kann aus mehreren Modellen bestehen
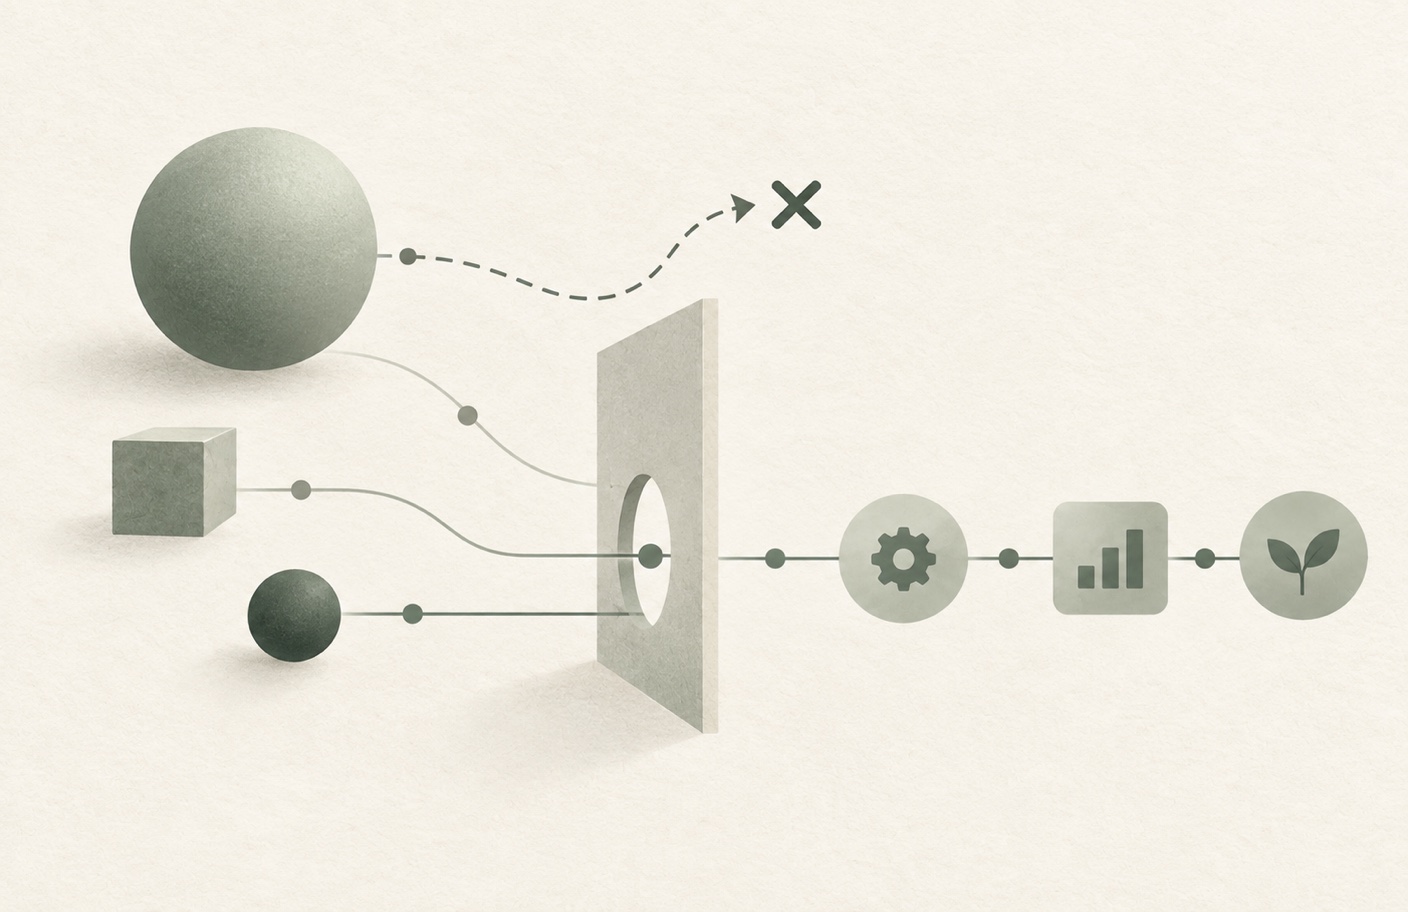
Die Entscheidung muss nicht für das gesamte Unternehmen einheitlich ausfallen. Ein günstiges, schnelles Modell kann einfache Anfragen sortieren. Ein leistungsfähigeres Modell übernimmt nur komplexe Fälle. Kritische Entscheidungen bleiben bei einer verantwortlichen Person. So richtet sich der Aufwand nach dem tatsächlichen Risiko statt nach dem Wunsch, überall dieselbe Technologie einzusetzen.
Dabei sollte der Prozess nicht unnötig an einen Anbieter gebunden werden. Klare Eingaben, definierte Ergebnisse und eine kleine Sammlung eigener Prüffälle erleichtern einen späteren Wechsel. Wer nur dokumentiert, welches Modell eingesetzt wird, hält eine Produktentscheidung fest. Wer zusätzlich dokumentiert, was der Prozess leisten muss, bewahrt seine Handlungsfähigkeit.
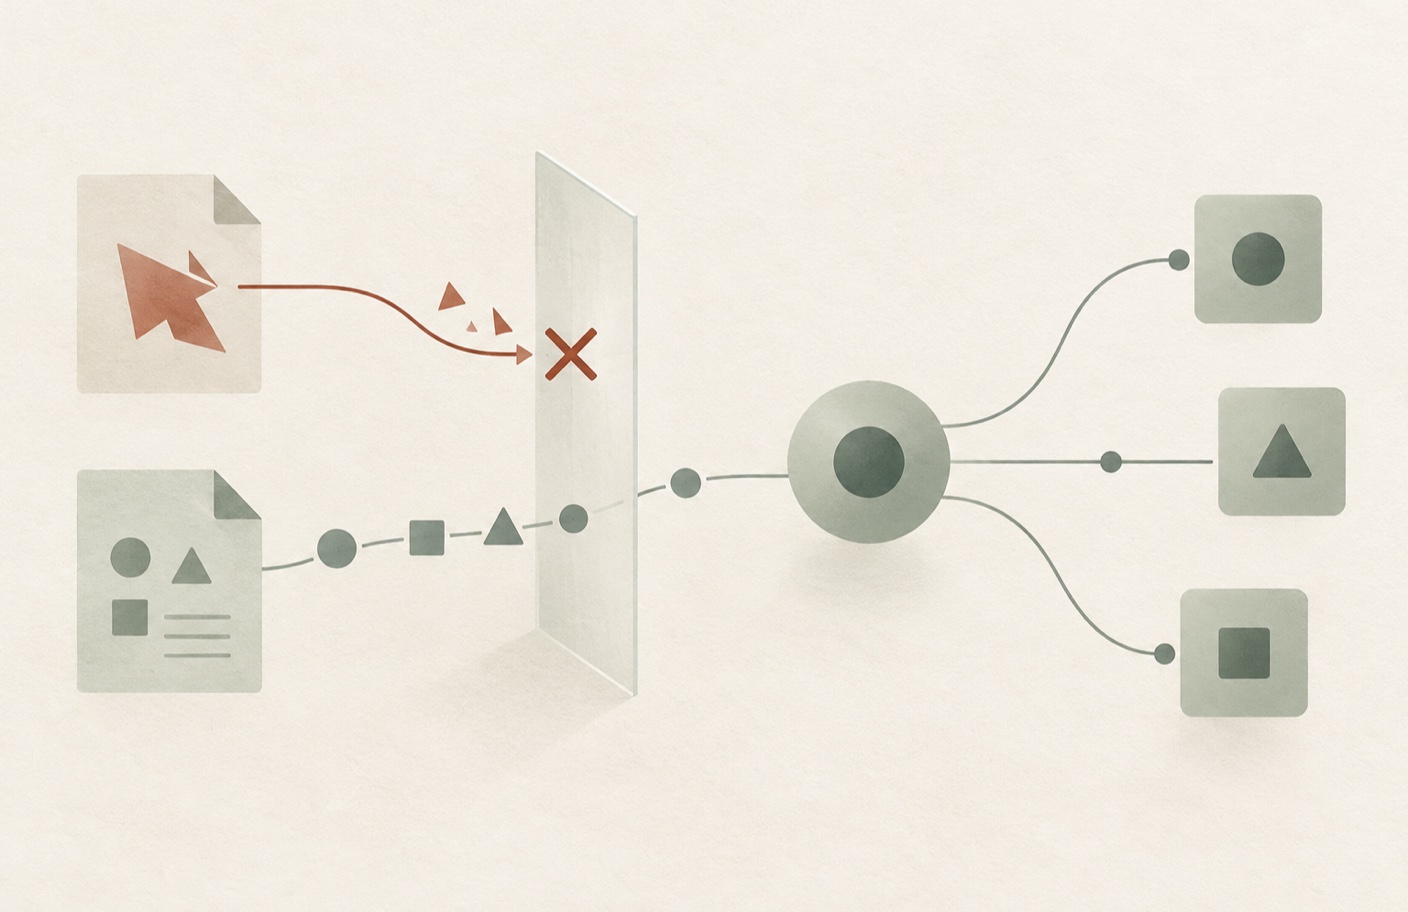
Diese Trennung ist auch für die Sicherheit wichtig. Ein fachlich gutes Ergebnis beweist noch nicht, dass Zugriffe und Aktionen angemessen begrenzt sind. Der Schutz vor Prompt Injection und unerlaubten Werkzeugaktionen bleibt eine eigene Aufgabe.
Modellauswahl ist eine Managemententscheidung
Die technische Leistungsfähigkeit eines Modells ist wichtig, aber sie ist nur ein Teil der Entscheidung. Hinzu kommen Fehlerfolgen, Nacharbeit, Datenschutz, Geschwindigkeit, Kosten und die Fähigkeit des Teams, den Ablauf zu kontrollieren. Diese Kriterien lassen sich nicht vollständig an eine Rangliste auslagern.
Für Entscheider folgt daraus eine angenehm nüchterne Konsequenz: Sie müssen nicht jeder Modellankündigung hinterherlaufen. Sie müssen ihren Prozess, das gewünschte Ergebnis und die tragbaren Fehler kennen. Genau dort beginnt eine belastbare KI-Strategie — und häufig stellt sich dann heraus, dass das beste Modell nicht das größte ist, sondern das passendste.